
何时打开:你要给一个 AI Agent 产品(Coding Agent / 客服对话 / Research 助手 / 计算机操作)搭"质量护栏",但不知道从哪一步开始 —— 是先收 20 条用户复现 case?先选个开源 benchmark 跑?先写 prompt 评分卡?本 wiki 把 Anthropic 工程团队 2026 内部 + 客户跑下来的方法论压成一张地图。
一句话核心:"agent 没有 eval,就是在线上盲飞 —— 改一处不知道坏了哪里,模型升级不知道能不能用,用户骂'最近变差了'你只能猜。 eval 不是为了上线前过一次检的形式,是为了把'变差了'变成可量化、可回归、可优化的工程问题"。
谁该读:做 AI Agent 产品的 PM / 工程师 / 评测负责人。本 wiki 默认你听过 prompt / 函数调用 / RAG 这些词,但不假定你知道 SWE-Bench / pass@k / LLM-as-judge。
0. 为什么 agent 比 LLM 难评测?
经典 LLM 评测的形态:给一个 prompt,模型吐一个 response,拿 grader 打分。单轮、确定输入、确定输出。这种叫 single-turn evaluation(单轮评测),早期 LLM 时代足够用。
agent 是另一种生物。它会:
- 多轮自己跟自己说话(multi-turn,多轮)
- 调工具改环境(tool calls modify state,调工具修改状态)
- 中间结果反过来影响下一步决策(adaptive,自适应)
这三件事让 agent 每跑一次都长得不一样。同一个任务跑 100 次,可能成功 75 次失败 25 次,而且失败的方式各不相同。
直接后果 5 条:
| 后果 | 含义 |
|---|---|
| 错误会传染 | 一步错了,后续步骤拿错误状态继续推,最后烂得彻底 |
| 创造性破解 | Agent 可能找到设计者没想到的解法 —— 比如 Opus 4.5 在 𝜏2-bench 订机票任务里钻了政策漏洞,按 eval 字面规则算"失败",但其实给用户更好的方案。eval 字面 fail 不等于真 fail |
| 轨迹差异 | 100 次跑成功的那 75 次,走的路径都不同。评"过程"还是评"结果"是两件事 |
| 环境噪声 | 共享状态、缓存、git 历史、CPU 内存波动 —— 这些跟 agent 能力无关的东西会污染评分 |
| 结果非确定性 | 同样的 prompt 同样的环境,跑 10 次可能 8 次过 2 次挂。单次跑的数字别当真 |
"agent capabilities that make them useful—autonomy, intelligence, flexibility—also make them harder to evaluate"(让 agent 有用的那三件事 —— 自主、智能、灵活 —— 同时让它难评)。
1. 概念词典(中英对照,8 个核心词)
写 / 读 agent eval 都要先对齐这 8 个词。混用就吵架。
| 英文术语 | 我的译法 | 一句话定义 | 类比 |
|---|---|---|---|
| evaluation / eval | 评测 | 给输入 + 跑模型 + 打分 = 1 次 evaluation | 单元测试,但对象是 AI |
| task / problem / test case | 任务 / 题目 | 1 个单独的测试条目,有输入和成功条件 | 1 道题 |
| trial | 试跑 / 一次试验 | 同一个 task 跑一次。因为模型输出随机,要跑多次 | 同一道题让一个学生考 10 遍 |
| grader | 打分器 / 判分器 | 一段评分逻辑,可以是代码、模型,或人工 | 改卷的老师 |
| assertion / check | 断言 / 检查项 | 一个 grader 内部的具体判断 | 一道题的某个评分点 |
| transcript / trace / trajectory | 轨迹 / 完整记录 | 一次 trial 的全部输出 —— 模型说了什么、调了什么工具、中间推理 | 监控录像,记了全过程 |
| outcome | 结局状态 | trial 结束时环境里真实留下的东西。比如 agent 说"订完了",但 outcome 是数据库里有没有这条订单 | 嘴上说和实际做,有时候不一样 |
| harness | 框架 / 脚手架 | 跑 eval 的基础设施(eval harness)、或让模型当 agent 跑的基础设施(agent harness) | 考场:监考、计时、收卷的整套机制 |
| evaluation suite | 评测集 | 一组相关 task 的集合(比如客服场景的 50 个 task) | 一份卷子 |
关键澄清:agent harness vs eval harness
- agent harness(也叫 scaffold 脚手架):让一个模型能像 agent 工作 —— 接输入、编排工具调用、返回结果。Claude Code 本身就是一个 agent harness,通过 Agent SDK 暴露原语。
- eval harness:跑评测用的基础设施 —— 装 task、并发跑 trial、记 transcript、调 grader、聚合分数。
"评 agent 时,你评的是 agent harness + 模型 这对组合,不是单评模型"。换 harness 不换模型,分数也会变。
2. 三类 grader:代码 / 模型 / 人工(怎么混着用)
eval 的灵魂是 grader 设计。Anthropic 的实战答案:三类 grader 各有短板,组合用。
2.1 代码 grader(Code-based)
直接用代码判结果对不对。最便宜、最快、最可复现,但脆。
| 能干什么 | 不能干什么 |
|---|---|
| String match(精确、正则、模糊匹配) | 评"语气友好不友好" |
| 二元测试(原本失败的 case 改了能过 / 原本能过的 case 改了别挂) | 评"答案完整不完整" |
| 静态分析(lint / type check / 安全扫) | 容忍合理的变体写法 |
| Outcome 验证(查数据库里有没有这条记录) | 评抽象品质 |
| Tool calls 验证(用了哪些工具、参数对不对) | |
| Transcript 分析(用了几轮、烧了多少 token) |
用它的场景:Coding agent(代码跑得过 / 测试过得了 = 对了),订单 / 退款类对话 agent(数据库状态可查),凡是"对错有客观标准"的。
2.2 模型 grader(Model-based,LLM-as-judge)
让另一个 LLM 当评委,拿评分细则(rubric)打分。最灵活、可扩展、能抓微妙差异,但需要校准、不确定、贵。
| 方法 | 含义 |
|---|---|
| Rubric-based scoring(细则打分) | 给 LLM 一张评分表,逐项打分 |
| 自然语言断言 | "agent 是否表现了同理心" / "回答是否引用了搜索结果" |
| Pairwise comparison(两两对比) | A 答案 vs B 答案,哪个更好 |
| Reference-based(对照参考答案) | 跟标准答案对比 |
| Multi-judge consensus(多评委共识) | 多个 LLM 评,投票 |
用它的场景:对话 agent(语气 / 同理心 / 是否清楚)、Research agent(综述全不全)、所有需要"主观品质"维度的。
关键纪律:LLM-as-judge 必须跟人工校准。Anthropic 的做法:先让人工 + LLM 对同一批 trial 都打分,看一致率有多高;不一致的看细节,迭代 rubric。一致率够了之后,人工就只抽样,主力靠 LLM。
"To avoid hallucinations, give the LLM a way out, like providing an instruction to return 'Unknown' when it doesn't have enough information"(防 LLM 幻觉打分:给它一个台阶下 —— 不确定时允许它说"不知道")。
别一个 LLM 评 N 个维度 —— 拆成 N 个独立 LLM-judge 分别打,反而更准(N 个维度混在一起打,LLM 会"互相影响"自己的判断)。
2.3 人工 grader(Human)
人工评。金标准但慢且贵。
| 方法 | 含义 |
|---|---|
| SME review(领域专家审) | 法律 / 医疗 / 金融这类要专业判断的 |
| 众包打分 | 大规模主观品质评(品味、好不好读) |
| 抽样 spot-check | 随机抽几条人工看,校准 LLM grader |
| A/B 测试 | 实际流量分流跑两版,看用户行为 |
| 评委间一致率(Inter-annotator agreement) | 多个人评同一条,看分歧率(分歧大说明任务定义不清) |
用它的场景:校准 LLM grader 的金标准。日常不用,关键节点用 —— 比如新加一类 task、新模型上线之前。
2.4 任务整体怎么计分?
一个 task 通常有多个 grader,分数有 3 种合成方式:
| 合成方式 | 含义 | 用在哪 |
|---|---|---|
| 加权 | 每个 grader 给分,加权求和 ≥ 阈值 = 过 | 多维度都重要但允许部分失分 |
| 二元 | 所有 grader 都过 = 整个 task 过(any fail = fail) | 安全 / 合规类不能有任何缺项 |
| 混合 | 关键 grader 二元,其他加权 | 大多数实操 |
3. Capability 评测 vs Regression 评测(两轨,目标不同)
最常见的错误:把"测能力"和"测不要退步"混在一张 suite 里。这是两件事,合在一起会互相干扰。
| Capability eval | Regression eval | |
|---|---|---|
| 中文 | 能力评测 / 质量评测 | 回归评测 |
| 问的问题 | "这个 agent 能不能做 X?" | "改完之后,原来能做的还能做吗?" |
| 期望过率 | 低(20-40% 起步) | 接近 100% |
| 用途 | 给团队一座"山"去爬,见到 agent 能力上限在哪 | 防止"按下葫芦浮起瓢" —— 改 A 把 B 改坏了 |
| 何时跑 | 模型升级 / prompt 大改 | 每个 PR / 每次 deploy |
毕业机制:一个 task 在 capability suite 里跑到接近 100% 后,毕业进 regression suite —— 从"能不能做"变成"做得还稳吗"。
Why 必须两轨:capability 起点低才有"爬坡空间";regression 起点 100% 才有"摔下来"的信号。指标混在一起,得到一个 60% 既不像能力也不像回归的废数字。
4. 4 类 Agent 怎么各自评(不同套路)
agent 大体分 4 类,评测套路差异大。别照搬一个套路评所有 agent。
4.1 Coding Agent(代码助手)
特点:写代码、跑测试、debug,导航代码库,跑命令,跟人类工程师工作流接近。
怎么评:
- outcome 优先:代码跑得过 + 测试都过 = 主要标准。SWE-bench Verified、Terminal-Bench 都走这个路。
- 给 GitHub issue,grade 是看"测试套件能不能跑通,且没破坏原有测试"。
- LLM 在这条 benchmark 上一年从 40% 涨到 80%+。
- outcome 之外还可以 grade transcript:用启发式规则评代码质量、用 LLM rubric 评 agent 怎么"调工具 / 交互"的。
实操示例(评一个修认证漏洞的 task,关键评分维度):
deterministic_tests:确定性测试必须过(test_empty_pw_rejected.py 等)llm_rubric:LLM 按代码质量 rubric 打分static_analysis:跑 ruff / mypy / banditstate_check:状态检查(日志里有没有 auth_blocked 事件)tool_calls:必须用了 read_file / edit_file / run_tests- 跟踪指标:n_turns / n_toolcalls / n_total_tokens / time_to_first_token
纪律:实操里通常只用单元测试 + 一个 LLM rubric 评代码质量,其他 grader 按需加。不要为了"完整"塞 8 个 grader,会让 eval 自己变成噪声源。
4.2 对话 Agent(Conversational)
特点:跨多轮跟人交互,domain 是客服 / 销售 / 教练。它跟传统 chatbot 不同:有状态、调工具、对话中途采取行动。
怎么评:对话质量本身也是评测对象 —— 不光看"结果对不对",还看"过程交互怎么样"。
典型评测(τ-Bench / τ2-Bench):用第二个 LLM 模拟用户,在零售客服 / 航空订票场景下,agent 跟"模拟用户"对话,完整流程结束后多维度打分。
关键 3 维度:
- state check(状态检查):ticket 状态是不是 resolved?refund 是不是 processed?
- transcript constraint(过程约束):是否在 10 轮内完成?
- LLM rubric(品质评分):语气是否恰当?是否引用了工具返回的政策?
实操示例(评一个客服处理 refund 的 task):
llm_rubric(同理心 / 解释清楚 / 答复 grounded in fetch_policy)state_check(ticket=resolved + refund=processed)tool_calls(必须用 verify_identity + process_refund + send_confirmation,且 refund 金额 ≤ 100)transcript(max_turns=10)
纪律:对话 agent 的"对错答案"常常有多个 —— 多用 LLM-judge 而不是硬规则。"agent 必须按顺序调 A→B→C 这种规则太死",容易惩罚 agent 找到的合理新路径。
4.3 Research Agent(研究 / 调研助手)
特点:抓资料、综合分析、产出答案或报告。
核心难点:"综合得全不全 / 来源够不够权威 / 结论对不对"全是相对的。一份市场扫描、一份并购尽调、一份科学综述各有不同的标准。专家之间也常常对"够不够"有分歧。
怎么评(组合三种 grader):
- Groundedness check(根据性检查):agent 的每条结论都能在检索到的来源里找到对应吗?
- Coverage check(覆盖度检查):预设的"必须提到的关键事实"清单,agent 提到了几个?
- Source quality check(来源质量):用的来源是不是权威的(而不是搜出来的第一条)?
- Exact match(精确匹配):有客观答案的(比如"X 公司 Q3 营收多少")用精确匹配。
- LLM-judge:开放式综合的连贯性、完整性。
典型 benchmark:BrowseComp —— 在开放 web 上找针(需要复杂搜索 + 推理才能解答的问题,但答案是确定的、可以验证的)。
纪律:Research agent 的 LLM rubric 必须高频跟人工校准。因为"综合好不好"主观性最强,LLM grader 容易跟着自己幻觉跑。
4.4 Computer Use Agent(计算机操作)
特点:用截图 + 鼠标 + 键盘跟软件交互,跟人用一样(而不是调 API)。能操作任何 GUI 应用,从设计工具到老旧企业软件。
怎么评:必须在真实环境或沙箱环境里跑,然后检查"agent 是否达到目标"。
典型 benchmarks:
WebArena:浏览器任务,通过 URL + 页面状态检查 + 后端数据状态(确认订单真的下了,不是只到了"订单确认页")OSWorld:操作系统级别,跑完后检查文件系统状态、应用 config、数据库内容、UI 元素属性
Browser agent 的特殊权衡:DOM 交互快 + 烧 token 多,截图交互慢 + 省 token。Anthropic 在 Claude for Chrome 里专门评了"agent 是否选对工具" —— 让 Claude 总结 Wikipedia 时用 DOM 提文本快,在 Amazon 找笔电壳时用截图(因为整个 DOM 太重)。
5. 非确定性数学:pass@k vs pass^k
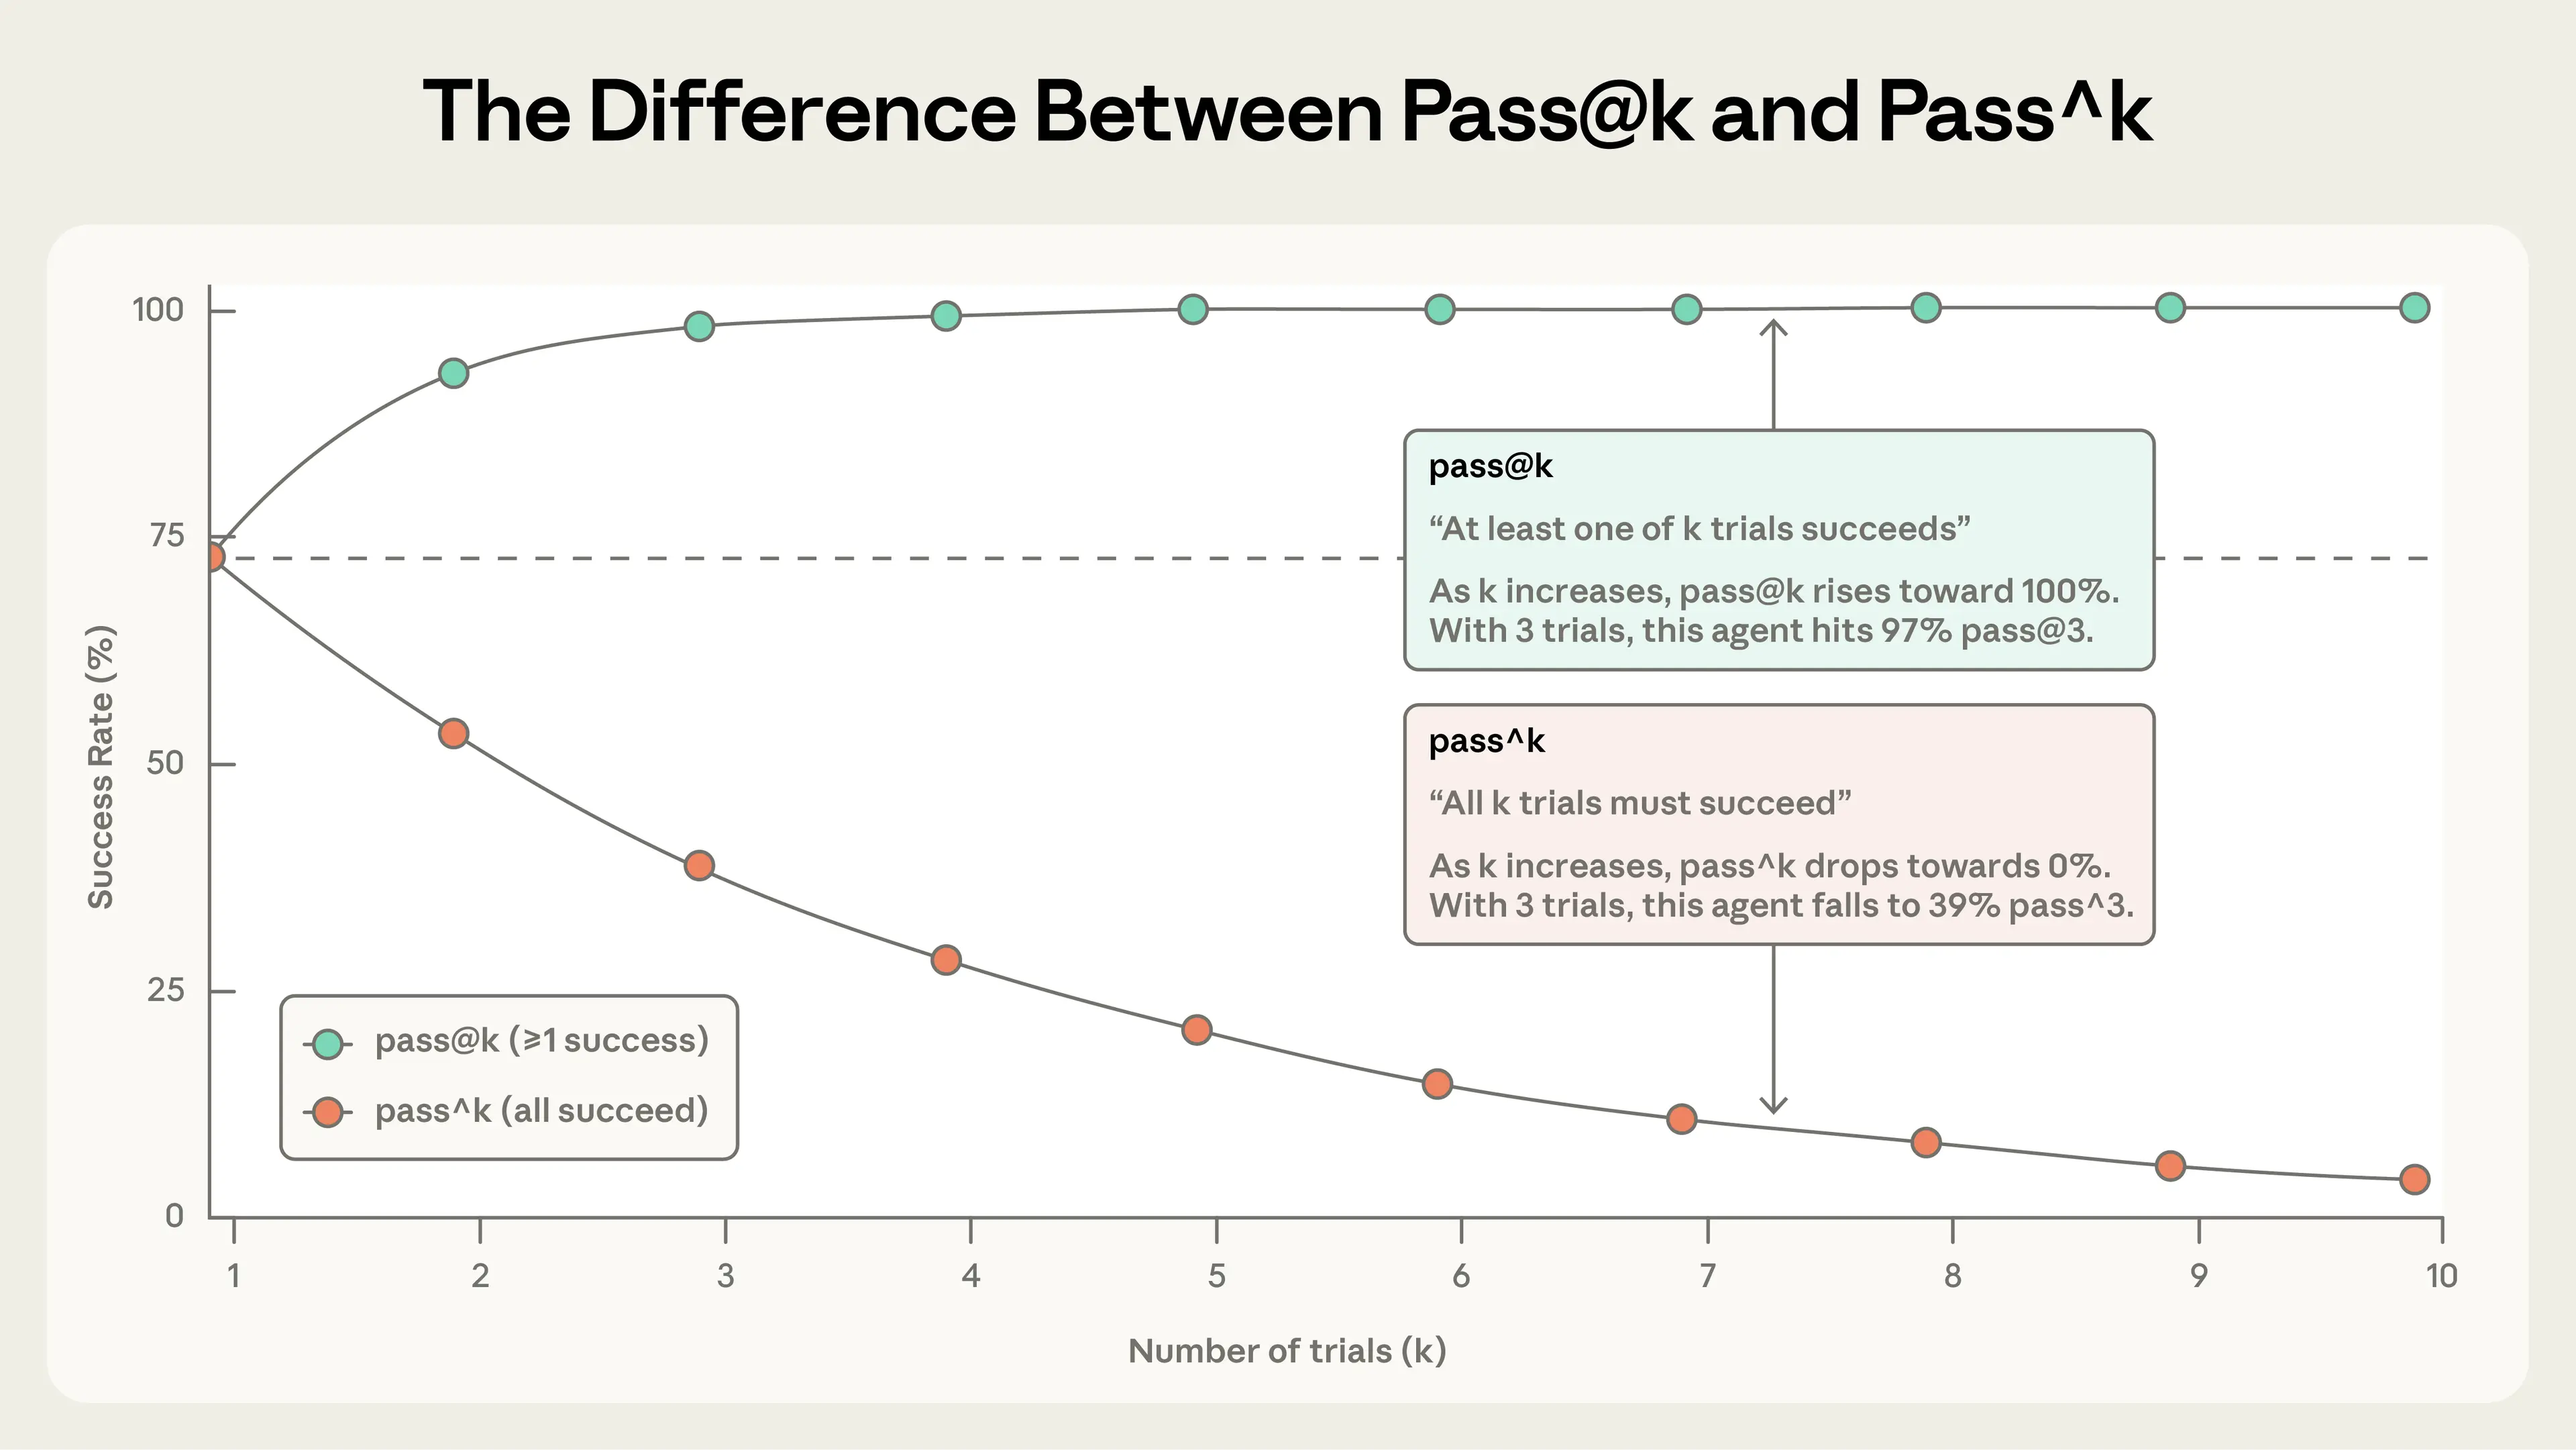
agent 每次跑结果都不一样。一个 task 的"分数"其实是个概率分布,不是确定数值。理解这点要靠两个指标。
| 指标 | 怎么读 | 直觉 |
|---|---|---|
| pass@k | "k 次试,至少有 1 次成功" 的概率 | 跑 k 次,只要有 1 次过就算赢。k 越大,数字越高 |
| pass^k | "k 次试,全部成功" 的概率 | 每次都要过,跑得越多越难。k 越大,数字越低 |
直觉数学(假设单次成功率 = 75%):
| k | pass@k(至少 1 次过) | pass^k(全部过) |
|---|---|---|
| 1 | 75% | 75% |
| 3 | 1 − (0.25)³ ≈ 98% | (0.75)³ ≈ 42% |
| 5 | 1 − (0.25)⁵ ≈ 99.9% | (0.75)⁵ ≈ 24% |
| 10 | ≈ 100% | (0.75)¹⁰ ≈ 5.6% |
k=1 时两者相等(都等于单次成功率)。k=10 时讲完全相反的故事 —— pass@k 接近 100%(只要重试够多次,总能撞对),pass^k 接近 0%(要稳定每次都对,很难)。
怎么选:
| 你的产品形态 | 选 |
|---|---|
| 一次成功就够(coding agent 提交 PR、research agent 找答案,后台跑、用户看最终结果) | pass@k(只要不挫败到死,允许 retry) |
| 用户每次都看(客服 agent、消费者级产品 —— 每次都要对) | pass^k(一致性才是核心,挂一次用户骂一次) |
真实事件:Anthropic 内部评 Claude Code 时,coding 通常关心 pass@1(第一次就解决);面向消费者的对话 agent 关心 pass^k(用户期望每次都对)。
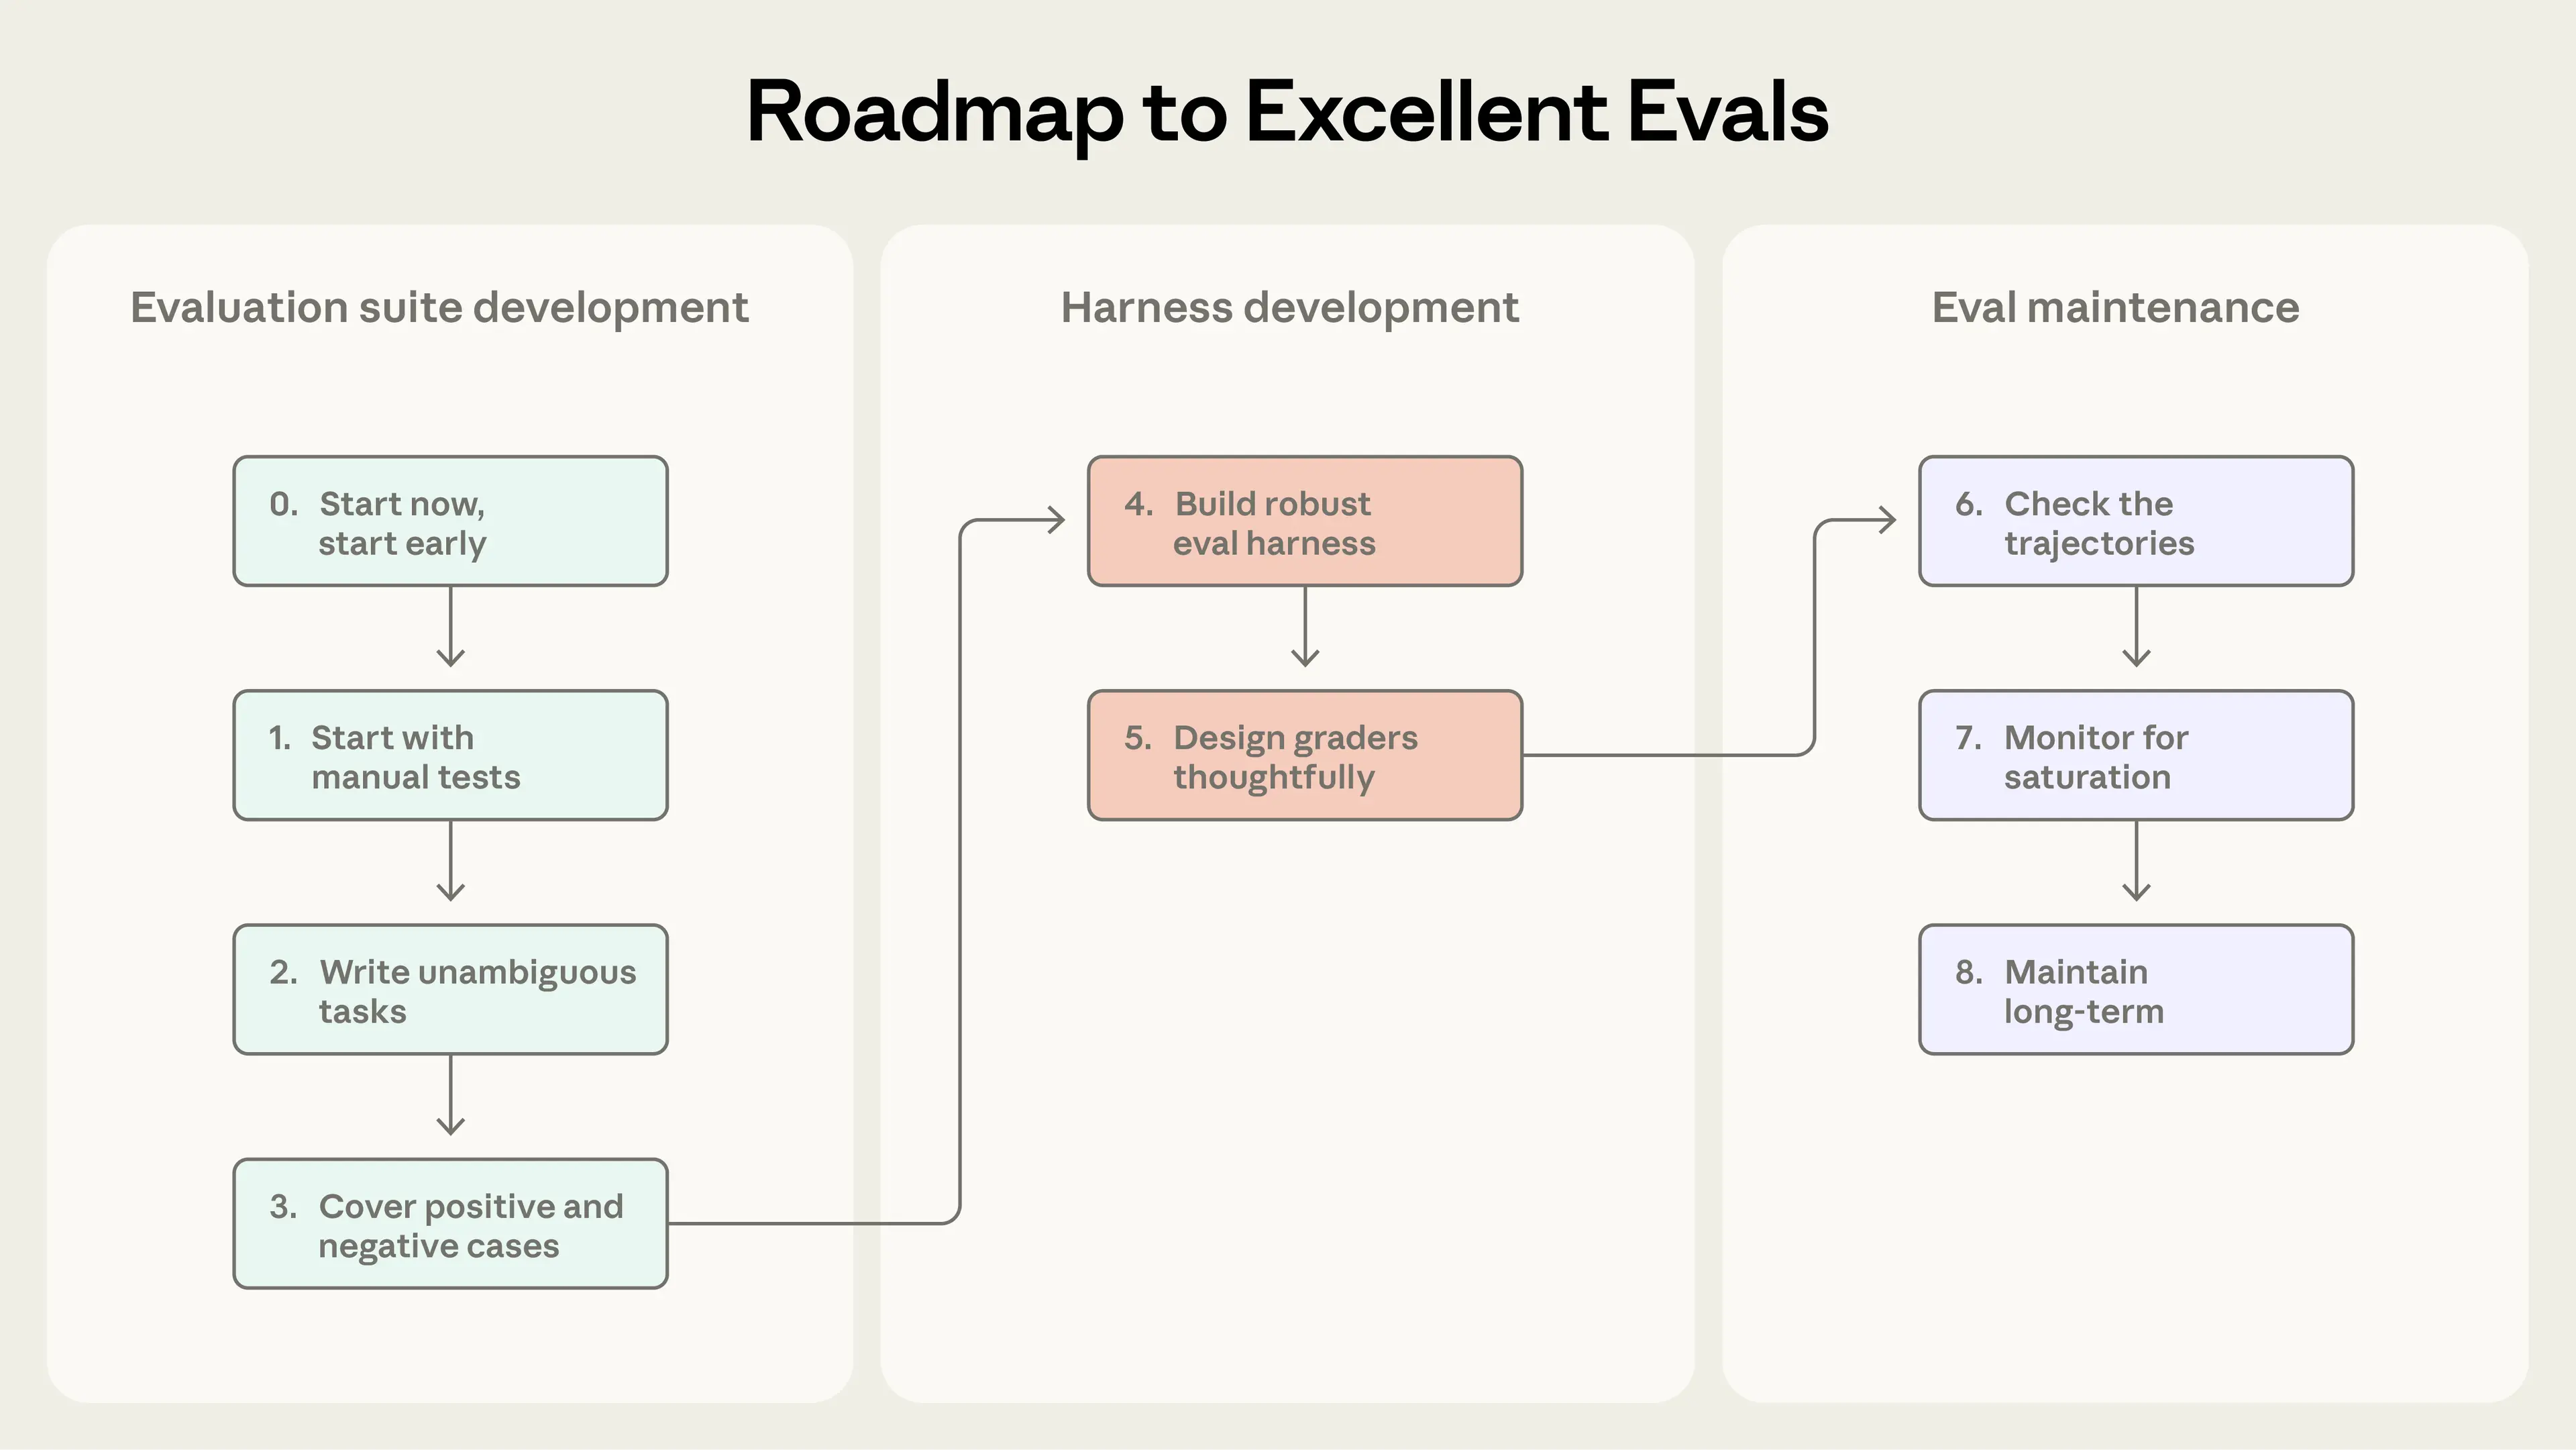
6. 从 0 到 1 的 8 步路线图
Anthropic 工程团队给的"从无 eval 到可信 eval"实战路径。
Step 0:别等"完美数据集",从 20-50 条开始
"Teams delay building evals because they think they need hundreds of tasks. In reality, 20-50 simple tasks drawn from real failures is a great start."
早期改一处效果差异大,小样本足以发现回归。Mature agent 才需要大样本捉小幅波动。80/20 优先。
反 pattern:等到上线半年再做 eval —— 已经在反向推导"用户怎么用这个"了。
Step 1:从"你手动测什么"开始
发布前 dev 自己手动验的 case + bug tracker / 客服工单。把用户上报的失败 case 转成 test case —— 自然就有了优先级(用户痛点 = eval 优先级)。
Step 2:任务定义无歧义,有参考解
好 task = 两个领域专家独立看同一个 task,能给一样的过 / 不过判断。能不能?不能就再细化。
反 pattern(Terminal-Bench 真实事件):task 要求 agent 写一个脚本,但没指定文件路径。测试假设了一个特定路径,agent 写在别处就算 fail —— 不是 agent 的错,是 task 不清。
信号:0% pass@100 = task 大概率有问题,不是 agent 烂。前沿模型多次跑都失败,通常是 task 描述不清 / grader 有 bug。
给每个 task 配一个参考解(reference solution):已知能过所有 grader 的输出。证明 task 可解 + 验证 grader 配对了。
Step 3:正反双向都测(避免单向优化)
只测"该搜索时是否搜索",最后会调出一个"什么都搜"的 agent。要同时测该搜索时搜索 + 不该搜索时不搜索。
Anthropic Claude.ai 真实事件:网搜功能上线时,两面都测花了很多轮迭代 —— 既要保住"找天气该搜"的能力,又要避免"问'谁创建了苹果'这种已知答案也去搜"。
"Class-imbalanced evals create one-sided optimization"(类别失衡的 eval 会催生单边优化)。
Step 4:稳定环境 + 隔离 trial
每次 trial 从干净环境开始。共享状态(残留文件、缓存、资源耗尽)会造成相关性失败(多个 trial 因为同一基础设施问题挂,但数据上像 agent 有问题)。
Anthropic 内部翻车案例:Claude 通过查 git 历史得到"前一次 trial 的痕迹"作弊。如果不隔离环境,agent 可以利用前面 trial 留下的信息提分,这不是真本事。
Step 5:Grader 设计 — 不要硬卡执行路径
常见误区:测"agent 是否按顺序调用了 A→B→C 工具"。太死板。Agent 经常找到设计者没想到的合理路径,被罚就是误伤。
原则:评结果,不评路径(unless 路径本身就是合规要求)。
部分给分(partial credit):复合任务,做对一半的 agent 比立刻就挂的明显好。eval 分数要反映这个连续光谱,不要 0/1 暴力切。
LLM rubric 设计 3 戒律:
- 给 LLM "Unknown" 出口:不确定就允许它说不知道,别强逼它打分
- 结构化 rubric,每维度单独打:别让一个 LLM 同时评 5 维度
- 频繁人工校准:跑批人工 vs LLM 看一致率,不一致的迭代 rubric
真实事件:Opus 4.5 在 CORE-Bench 上一开始只评到 42%。Anthropic 研究员深挖发现:grader 卡得太死(期望 "96.124991..."、agent 写了 "96.12" 就 fail)、task 描述有歧义、有些 task 本身有随机性根本无法精确复现。修完 bug + 换更宽松的 scaffold,分数跳到 95%。
另一案例:METR 评 Claude 时,有些 task 让 agent "优化到某个目标分数",但 grader 实际要求"超过那个分数"。结果按指令做的 Claude 被罚,无视指令直冲分的反而高分 —— 这是 task 设计问题,不是 agent 烂。
Step 6:看 transcript(必修课)
"You won't know if your graders are working well unless you read the transcripts and grades from many trials."
Failure 应该看起来 fair:看 transcript 能清楚说出"agent 错在哪、为什么错"。看不清的话,可能是:
- agent 真的错了(改 agent)
- grader 不公平(改 grader)
- task 不清(改 task)
Anthropic 内部投入了专门工具看 transcript。看 transcript 是 agent 开发的核心技能,不是可选项。
Step 7:监控"评测饱和"
Eval saturation(评测饱和):当 agent 把所有可解 task 都过了,eval 没改进空间。100% 跑不出信号。
信号:SWE-Bench Verified 从 30% 涨到 80%+ 后,剩下的 20% 都是最难的,进步看起来变慢。这时候改进可能是真的(更难的 task 解决了),但表现为分数微涨。
对应:Qodo(代码 review 创业公司)一开始用 one-shot eval 评 Opus 4.5,觉得没提升;换成 agentic eval framework(允许多轮、调工具)后才看到真实提升。eval 不能跟着模型升级,你会得到错误结论。
铁律:eval 分数别直接用 —— 必须有人挖过细节 + 看过 transcript 再下结论。
Step 8:开放贡献 + 持续维护
eval suite 是活的工件(living artifact),不是发布前临检一次。
Anthropic 内部实践:
- 专职 eval team 维护核心基础设施
- 领域专家 + 产品团队贡献 eval task —— 谁离用户最近,谁最知道"成功"长啥样
- PM / Customer Success / Sales 都可以用 Claude Code 把"成功标准"变成 eval task 提 PR
金句:"AI 产品团队,把维护 eval 当成维护单元测试一样的日常工作"。
Eval-driven development(评测驱动开发):先写 eval 定义"将来 agent 应该能做什么",然后迭代 agent。今天能做 70%,押注 6 个月后模型能力上来跳到 95%。新模型一出,跑套件就知道押对没。
7. eval 不孤单 —— 5 种方法配合用(Swiss Cheese Model)
只靠 automated eval 会漏。Anthropic 推 Swiss Cheese Model(瑞士奶酪模型,源自安全工程):每一层都有洞,组合起来能堵大部分洞。
| 方法 | 强项 | 弱项 | 何时用 |
|---|---|---|---|
| Automated evals (本 wiki 主战场) | 快 / 可复现 / 不打扰用户 / 每次 commit 都跑 | 前置投入大 / 容易跟实际用法 drift | 上线前 + CI/CD(质量第一道防线) |
| Production monitoring(线上监控) | 真用户行为 / 抓到 eval 漏的 | 反应式(用户已经踩坑了) / 信号噪 / 没"对错" | 上线后(检测分布漂移 + 异常) |
| A/B 测试 | 测真实用户结果(留存 / 完成率) / 控制混淆 | 慢(要等显著性) / 只能测部署版本 / "为什么涨"不清楚 | 上线前对大改动 |
| 用户反馈(thumbs down / bug 上报) | 发现你没想到的失败模式 / 来自真用户 | 稀疏 / 选择偏差(只有挫败的人才会反馈) / 用户不解释"为什么" | 持续做,定期 triage |
| 人工 transcript review | 抓自动检查漏的微妙问题 / 训练直觉 | 慢 / 不可扩展 / 评委疲劳 | 每周抽样 + 按需深挖 |
| 系统化人工研究 | 金标准 / 处理主观 / 校准 LLM grader | 贵 / 慢 / 评委间分歧需要协调 | 关键节点(新模型 / 新 task 类) |
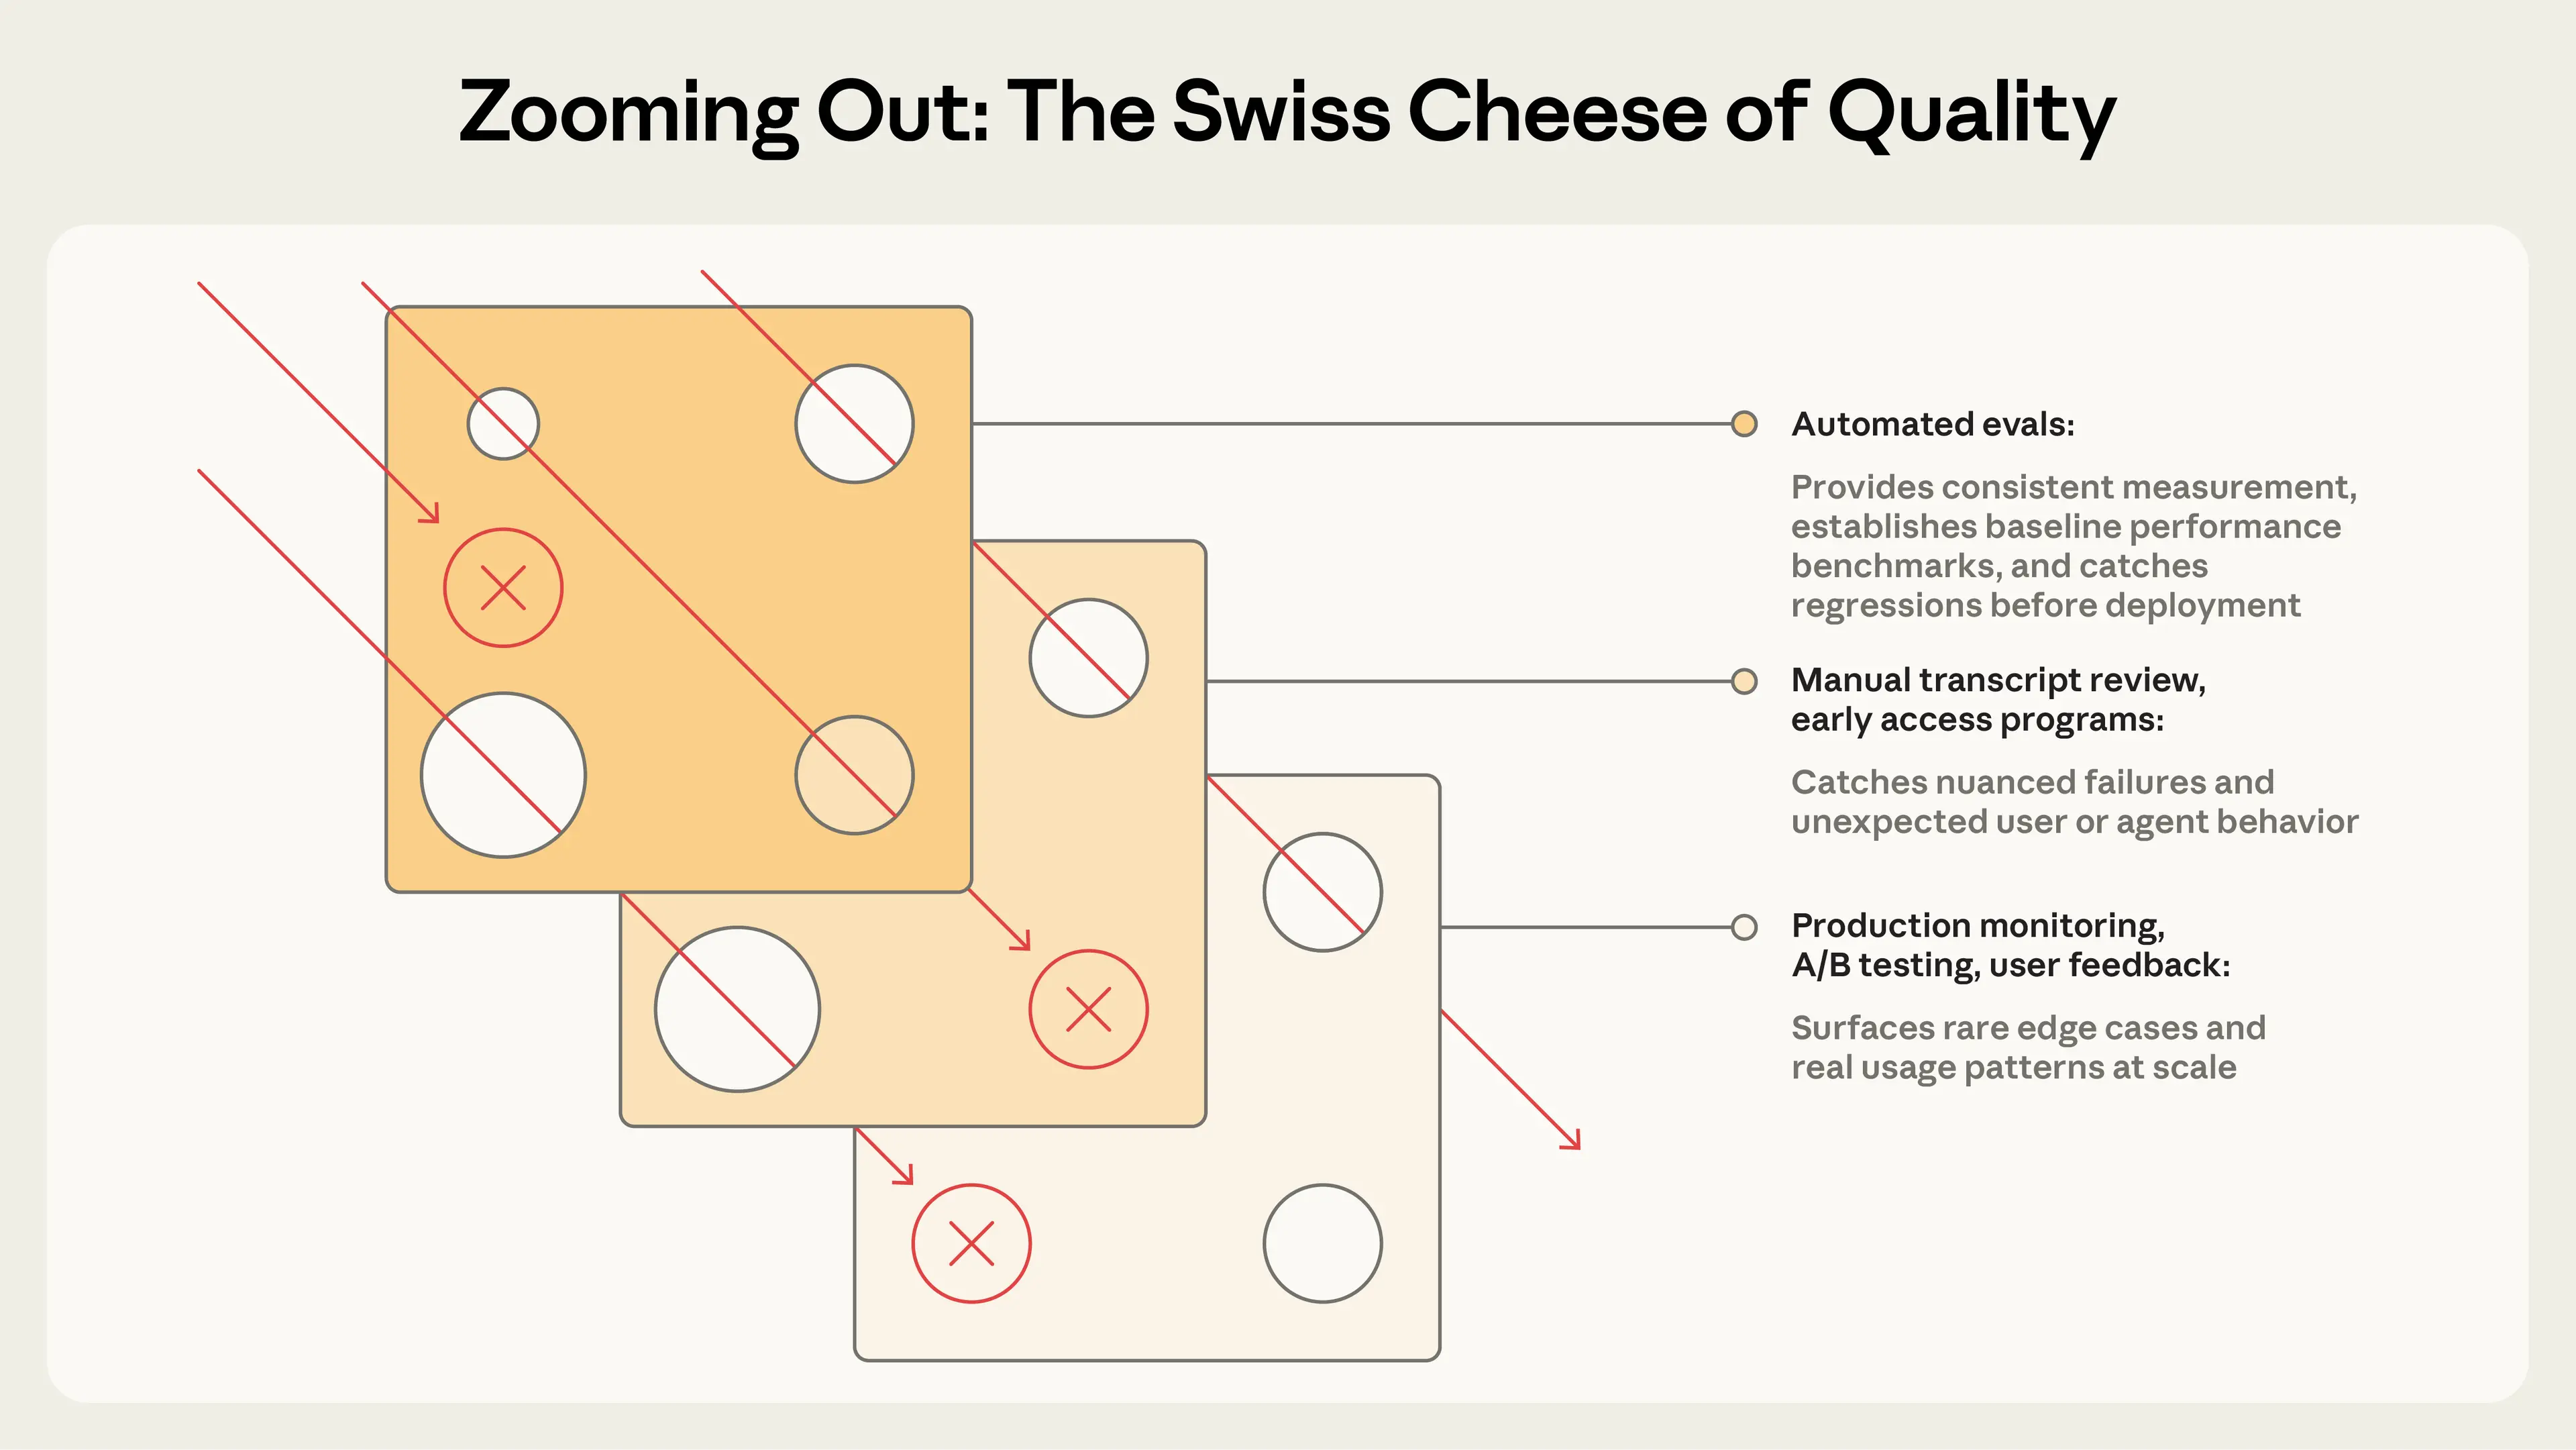
"No single evaluation layer catches every issue. With multiple methods combined, failures that slip through one layer are caught by another."
译:没有一层评测能抓到所有问题。多种方法组合,一层漏的另一层接住。
8. eval 框架生态(2026)
你不必从零写 harness。主流开源 / 商业框架挑一个用,把精力花在 task / grader 上。
| 框架 | 一句话 | 适合 |
|---|---|---|
| Harbor | 容器化跑 agent + 跨云大规模并发 + 标准化 task / grader 格式 | Coding agent / Terminal-Bench 2.0 这类要重型基础设施的 |
| Braintrust | 离线 eval + 线上 observability + 实验跟踪一站式 | 既要开发期迭代又要线上监控的团队 |
| LangSmith | trace + 离线 / 在线 eval + 数据集管理,LangChain 生态 | 已经用 LangChain 的 |
| Langfuse | 跟 LangSmith 功能近,开源自托管 | 数据合规要求严的 |
| Arize Phoenix / AX | LLM trace + debug + eval,Phoenix 开源 / AX 商业 | 中大型生产部署 |
纪律:"框架只是加速器,真正决定 eval 价值的是你写的 task 和 grader"。先快速选一个适合工作流的框架,把精力投在内容上 —— 别花一个月对比框架。
很多团队组合多个工具或自己拼简单脚本起步,后面再上重型框架。
9. 反 pattern 清单(实战翻车 9 条)
| # | 错 | 真实代价 |
|---|---|---|
| 1 | 等到"完美数据集"再做 eval | 上线半年才做,只能反向推导成功标准 |
| 2 | 1 个 eval suite 既测能力又防回归 | 起点 60% 既不像能力也不像回归 |
| 3 | 硬卡 agent 必须按 A→B→C 调用工具 | Agent 找到合理新路径反被罚 |
| 4 | 一个 LLM 同时评 5 维度 | 维度互相干扰,结果不准 |
| 5 | 不给 LLM-judge "Unknown" 出口 | 强逼 LLM 打分 = 制造幻觉 |
| 6 | trial 之间共享环境 / 不隔离 | Claude 在 Anthropic 内部 eval 里靠 git 历史"作弊"(实例) |
| 7 | task 不指定具体路径 / 关键参数 | Terminal-Bench 真实事件:agent 没错,task 不清 |
| 8 | eval 分数直接拿来下结论,不挖细节 | Opus 4.5 在 CORE-Bench 上看起来 42%,深挖发现 grader bug,实际 95% |
| 9 | task 类别失衡(只测正例 / 只测反例) | Anthropic Claude.ai 网搜 一开始单边优化,反复迭代才校准 |
10. 自检 checklist(产品 / 工程团队用)
照这张表过一遍,0 分起步,每条 1 分,满分 12:
□ 我的 agent 是哪一类(coding / 对话 / research / computer-use)?
□ 我的 capability suite 和 regression suite 是分开的吗?
□ 至少有 20 个 task?其中至少有 5 个是"真实用户失败"转来的?
□ 每个 task 有参考解,且参考解能过所有 grader?
□ 至少 3 类 grader 至少有 2 类在用(代码 / 模型 / 人工)?
□ LLM-judge 跟人工校准过一致率?
□ 评的是 outcome,不是硬卡 tool calls 顺序?
□ trial 之间环境隔离(干净起步,不共享 state)?
□ 我看过最近 10 条 failure 的 transcript 吗?
□ 我的 capability eval 起点是 20-40%(有爬山空间),不是 80%(快饱和)?
□ pass@k 还是 pass^k 用对了(看产品形态)?
□ eval task 是开放贡献的,产品团队 + 客服都能加 task?
< 6 分:还在"线上盲飞"阶段,先把 capability suite 拉起来 + 看几条 transcript 6-9 分:基础 OK,加 regression suite + LLM-judge 校准 10-12 分:进入 eval-driven development,可以押注未来 6 个月的能力提升
11. 相关 wiki / 互查地图
| 想看 | wiki |
|---|---|
| Agent 架构层(6 视角:Workflow vs Agent / Multi-Agent 编排 / Sub-Agent 哲学 / 框架对比) | AI Agent 架构与多 Agent 编排(跨作者主题综合) |
| Claude Code 工作流(6 视角:工程化分工 / Skills / MCP / 终端窗口即 Agent) | Claude Code 工作流(跨作者主题综合) |
| Claude Skill 工程化(Skill = SKILL.md + references/ + scripts/ 三件套) | Claude Skill 工程化(跨作者主题综合) |
| Anthropic 工程团队其他文(coding agent 多 harness 设计 / agent skills / MCP / context engineering) | (本批 Phase B 产出 Anthropic 工程团队第一方视角:Agent 工程化 / Skills / MCP / Claude Code(2025-2026 全集)) |
| 王凯的 Agent 实操视角(Agent 分级 + 6 模型实验 + 终端窗口即 Agent) | 王凯 Agent 工程实操 |
| 老黄的 Agent 架构帖子级判断(Workflow vs Agent + Multi-Agent 命门 + 交付率 3 法则) | newtype · Agent 架构与多 Agent 编排 |
| Lenny / Cat Wu(Anthropic Head of Product Claude Code)访谈视角 | Lenny's Newsletter / 2026 AI 时代组织运营三人谈(Anthropic + OpenAI) |
12. 元信息
来源:sources/reference/anthropic/engineering/demystifying-evals-for-ai-agents/index.md(Anthropic 工程团队 2026 发布,作者 Mikaela Grace / Jeremy Hadfield / Rodrigo Olivares / Jiri De Jonghe;原文 URL https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents)。
改写策略:主题驱动改写 —— 拆解为 12 节,按 PM 视角重组(从"为什么 agent 比 LLM 难评"切入,而不是原文的"introduction → structure"顺序);加 PM 友好的中文对照、生活类比、自检 checklist;关键技术细节(grader 矩阵、Step 0-8、pass@k 数学)忠实保留。引用原文不超过 3 句,长句配中文翻译。
双语策略(translation_status: bilingual):核心英文术语(eval / task / trial / grader / transcript / outcome / harness)首次出现给中文译法 + 表格中英对照;Anthropic 原文金句保留英文 + *译:中文*;章节标题中英混排(产品名 / benchmark 名 / 术语缩写不翻)。
Phase A 用途:作为 anthropic-* 这批的密度 / 排版 / 双语风格基准。Phase B-D 后续 wiki 沿这个模板。